01 / BACKGROUND
为什么用算法评烟叶
烟叶感官质量长期依赖专业评吸——由持证评吸员对香气质、香气量、杂气、余味、刺激性等指标人工打分。这套体系沉淀了深厚的行业经验,但也存在三重结构性瓶颈:
🧑🔬主观依赖
评吸结果依赖专家个体经验与参照系,不同评吸员之间存在尺度差异,跨产区、跨年度数据难以直接比较与积累。
😮💨生理疲劳
评吸高强度刺激口腔与鼻腔,长时间作业导致感知敏感度下降,同一样本在不同时段可能得到不同结论。
📦黑箱作业
只输出"多少分",缺乏量化的归因分析——无法回答"为什么是这个分数",更难以反向指导种植与调制工艺。
02 / DATA ASSETS
993 份样本的多维数据资产
项目整合 2023–2025 年贵州 9 个市州主产区的定点监测数据,覆盖中、上部烟叶与蜜甜、清甜两大香型,每份样本同步采集外观分级、物理检测、化学分析与感官评吸结果。
样本画像
| 维度 | 构成 |
|---|
| 年份 | 2023(163)· 2024(372)· 2025(458) |
| 产区 | 遵义 · 毕节 · 贵阳 · 黔南 · 安顺 · 黔东南 · 铜仁 · 六盘水 · 黔西南 |
| 部位 | 中部(615)· 上部(378) |
| 香型 | 蜜甜(698)· 清甜(295) |
| 感官总分 | 均值 70.62 · 标准差 4.16 · 区间 51.47–81.91 |
指标体系(21 维客观指标 + 6 维感官评价)
每份样本横跨四大指标域,形成"外观 → 物理 → 化学 → 感官"的完整证据链:
外观 6 项颜色成熟度结构身份油分色度
物理 5 项叶长叶宽单叶重含梗率叶面密度
化学 10 项烟碱总糖还原糖总氮钾氯糖碱比氮碱比钾氯比两糖比
感官目标 6 项香气质香气量杂气余味刺激性感官质量分
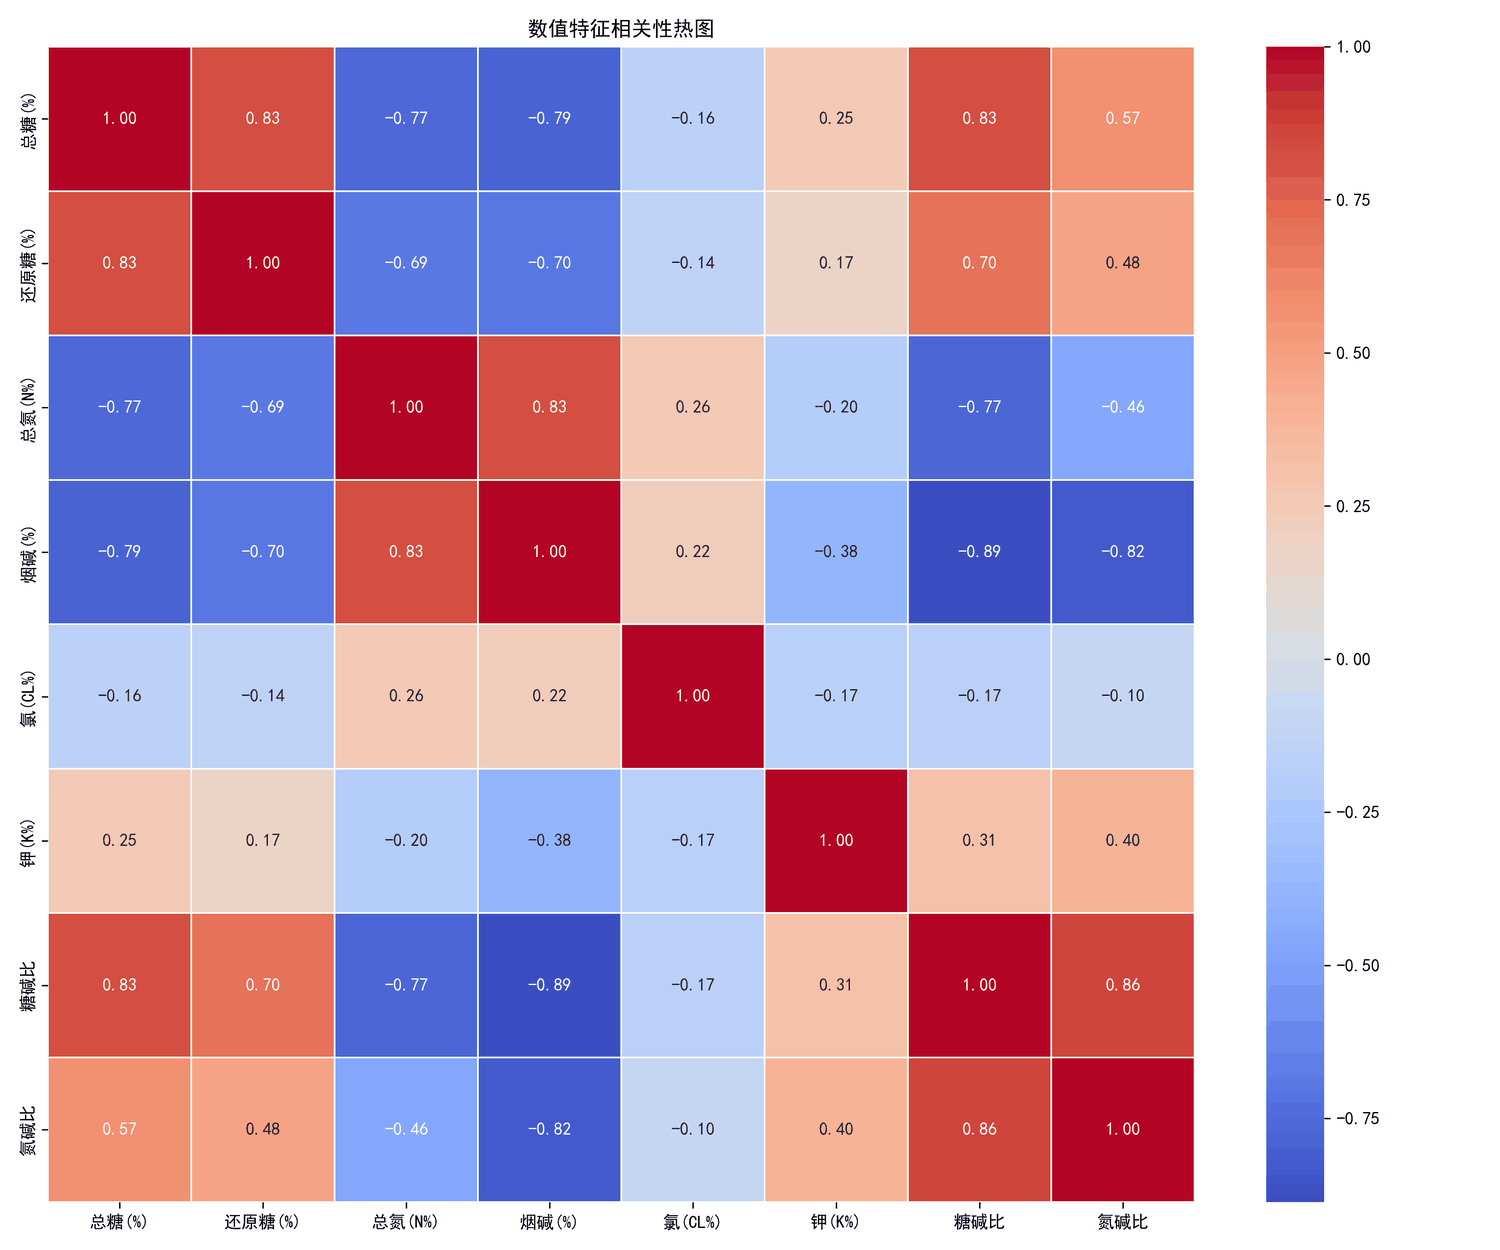 FIG.0121 项理化指标与感官质量分的相关性热力图。糖碱比与烟碱强负相关(r = −0.89)、总糖与还原糖强正相关(r = 0.83)、结构与身份正相关(r = 0.79)——化学指标间存在显著共线性,是特征工程阶段 VIF 检验的直接动因。
03 / METHODOLOGY
六阶段建模技术路线
从原始表格到可部署模型,全流程覆盖数据治理 → 特征工程 → 模型竞争 → 分区验证 → 分项预测 → 综合判定,每一步均产出可复核的中间产物。
数据治理
缺失值中位数插补 · IQR 异常值检测 · Z-Score 标准化 · 训练/验证/测试集划分
特征工程
VIF 共线性检验(<10)· 灰色关联分析 · PCA 降维 · 树模型重要性筛选,最终锁定 15 项核心特征
全模型竞争
线性 / 正则化 / 决策树 / 随机森林 / XGBoost / LightGBM / SVR / 神经网络等 12 种模型同台竞技
网格调参 + 交叉验证
GridSearch 超参数寻优 · 5 折交叉验证评估稳定性 · 训练集与测试集双指标监控过拟合
分区与分项建模
按市州 / 年份 / 部位建立独立子模型对比统一模型;对 5 个感官分项分别建模
综合判定与解释
优 / 良 / 中 / 差四级分类模型 · SHAP 归因分析 · 业务洞察输出
灰色关联分析 · Top 关联指标
量化各项理化指标与感官质量分的灰色关联度,成熟度、颜色等外观分级指标关联最强:
| 指标 | 关联度 | 指标 | 关联度 |
|---|
| 成熟度 | 0.759 | 含梗率 | 0.646 |
| 颜色 | 0.753 | 单叶重 | 0.626 |
| 身份 | 0.750 | 总氮 | 0.610 |
| 油分 | 0.740 | 烟碱 | 0.599 |
| 总糖 | 0.736 | 糖碱比 | 0.529 |
特征工程关键产物
- ▸VIF 检验:识别总糖 / 还原糖 / 糖碱比等高度共线变量,剔除冗余维度
- ▸PCA 降维:按累计方差贡献率 ≥ 85% 确定主成分数
- ▸最终特征集(15 项):还原糖、叶长、叶宽、总氮、结构、身份、钾、两糖比、叶面密度、含梗率、色度、氮碱比、烟碱、钾氯比、单叶重
- ▸编码策略:数值特征标准化 + 部位 / 香型 One-Hot 编码
04 / RESULTS
模型竞技场:三个层次的预测能力
不同信息输入条件下,模型可达到的预测精度不同。项目以"盲预测 → 融合外观 → 综合评价"三个层次递进验证,诚实界定算法能力边界。
LEVEL 1
纯理化指标盲预测
8 项化学指标 + 部位 / 香型
Stacking 集成模型:R² = 0.326 · RMSE = 3.11 分 · MAE = 2.40 分 · ±3 分命中率 67.3%
完全不依赖任何人工评分,仅凭化学检测数据预测人工感官分——多算法(SVR / PLS / Stacking / 调优后 SVR 0.337)在 R²≈0.33 处收敛,标示了纯理化信息对人工感官分的可解释上限。
LEVEL 2
全维度特征融合
19 项理化与外观指标 + 产区 / 年份 / 部位 / 香型
感官分 Stacking:R² = 0.38 · RMSE = 2.99 分 | 综合总分 Stacking:R² = 0.66 · RMSE = 2.12 分(原报告随机森林 0.640 即总分口径)
纳入外观分级、物理性状与产区年份后,感官分预测由 0.33 升至 0.38;综合总分因感官分占其 63.5% 权重、且与外观 / 物理 / 化学三维高度关联,可预测性显著更高——客观检测与结构化专家经验互补,是当前性价比最高的投产形态。
LEVEL 3
综合质量评价框架
外观 / 物理 / 化学 / 感官多维质量分体系
质量四级判定(优 / 良 / 中 / 差):完全一致率 67.8% · 相邻 ±1 级一致率 98.0%
按无泄漏口径(特征不含总分组分)重估:199 份测试样本 135 份完全一致,主要混淆集中于"中↔良"边界(57 例),跨两级误判仅 4 例。早期报告的 98% 源于特征含总分组成项(信息泄漏),本页已修正——跨级可信、边界需人工复核,是分级辅助的合理定位。
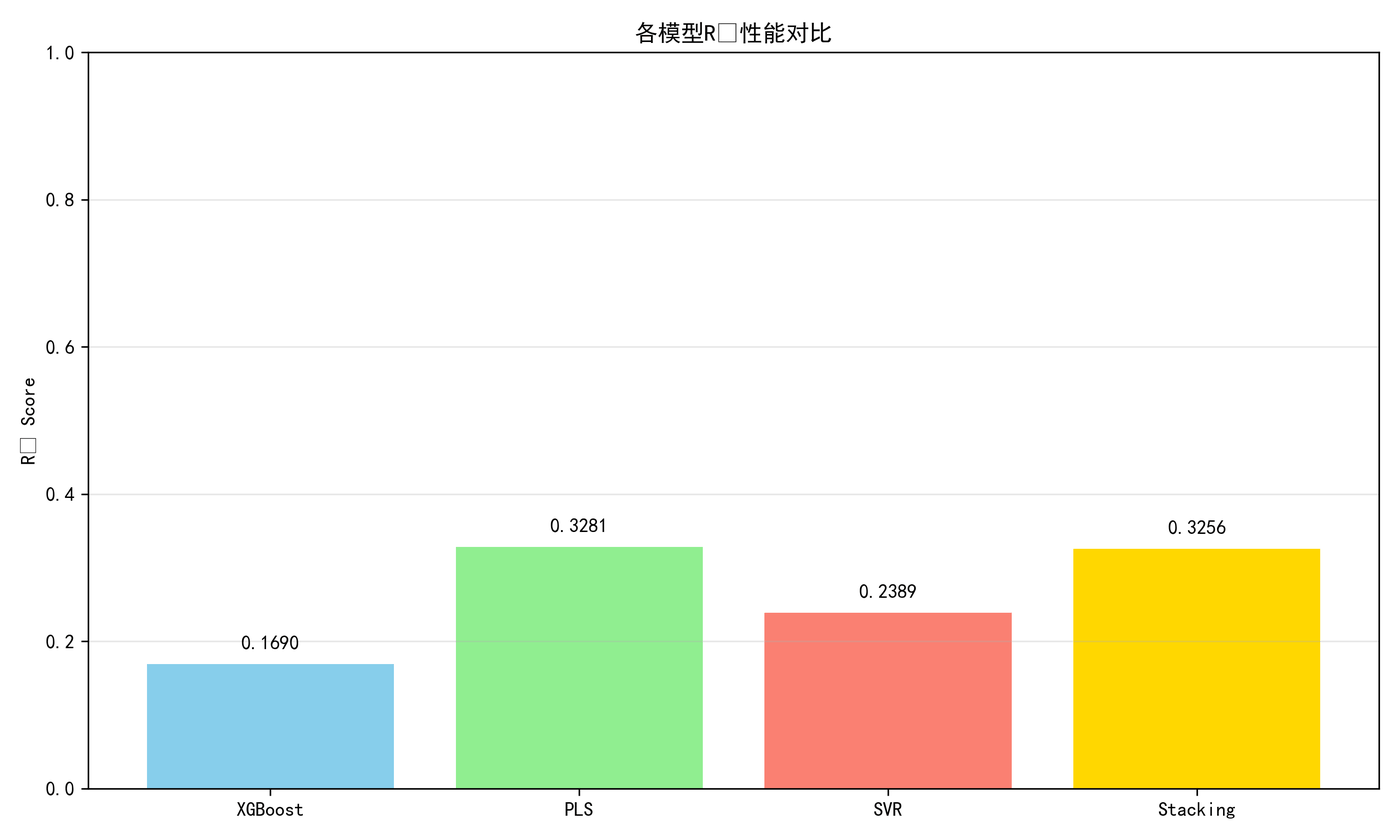 FIG.02最终交付版四种模型 R² 对比:PLS(0.328)与 Stacking(0.326)领先于 SVR(0.239)与 XGBoost(0.169)。
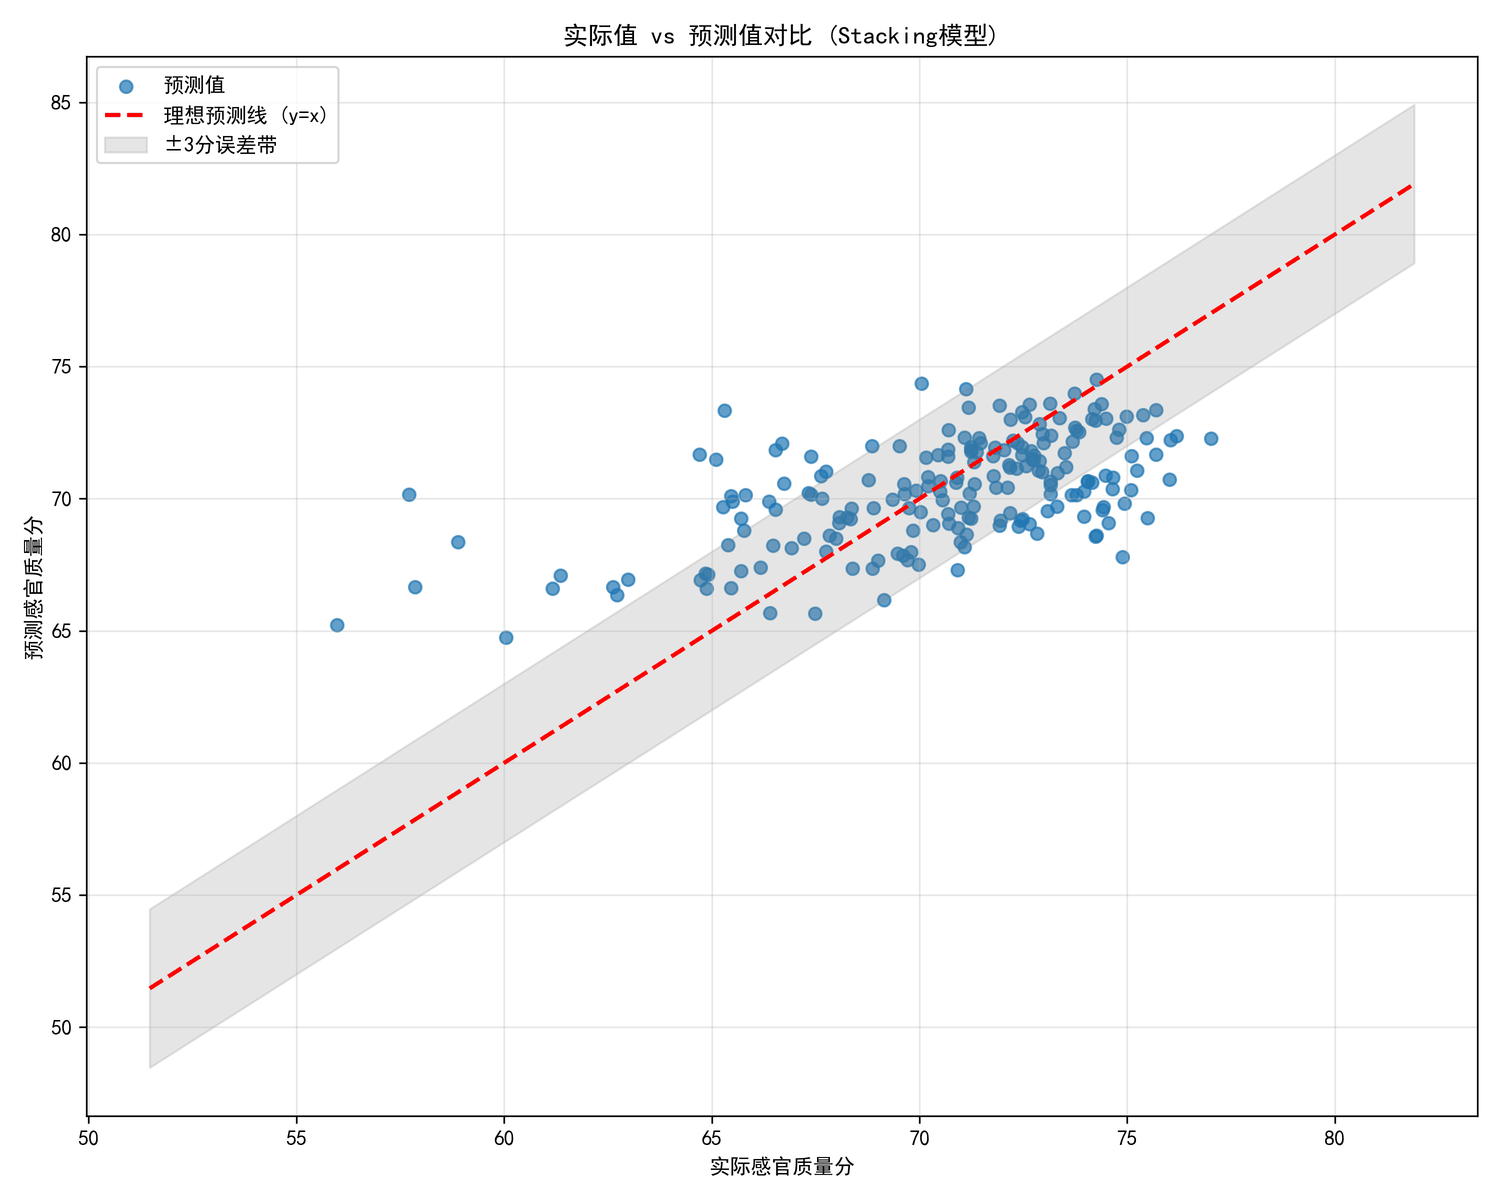 FIG.03Stacking 模型预测值 vs 实际感官分:散点沿理想线分布,绝大多数落入 ±3 分误差带。
| 模型 | 测试集 R² | 测试集 RMSE | 测试集 MAE | 测试集 R²(网格调参后) | 结论 |
|---|
| 随机森林 | 0.350 | 3.06 | 2.33 | 0.330 | 基线最优,稳健抗过拟合 |
| SVR | 0.312 | 3.15 | 2.35 | 0.337 | 调参后最优(C=10, γ=0.01) |
| 梯度提升树 | 0.298 | 3.18 | 2.41 | 0.329 | 集成方法稳定居前 |
| 线性回归 / 岭回归 | 0.271 | 3.24 | 2.48 | 0.271 | 可解释性基准 |
| XGBoost | 0.250 | 3.28 | 2.51 | — | 训练集 R²≈1.0,过拟合显著 |
| LightGBM | 0.246 | 3.29 | 2.49 | — | 同类表现 |
| LASSO | 0.204 | 3.38 | 2.59 | — | 正则化压缩部分特征 |
| 决策树 | −0.377 | 4.45 | 3.47 | — | 单树泛化失败 |
| 神经网络 | −3.436 | 7.99 | 6.31 | — | 千级样本下深度模型失效 |
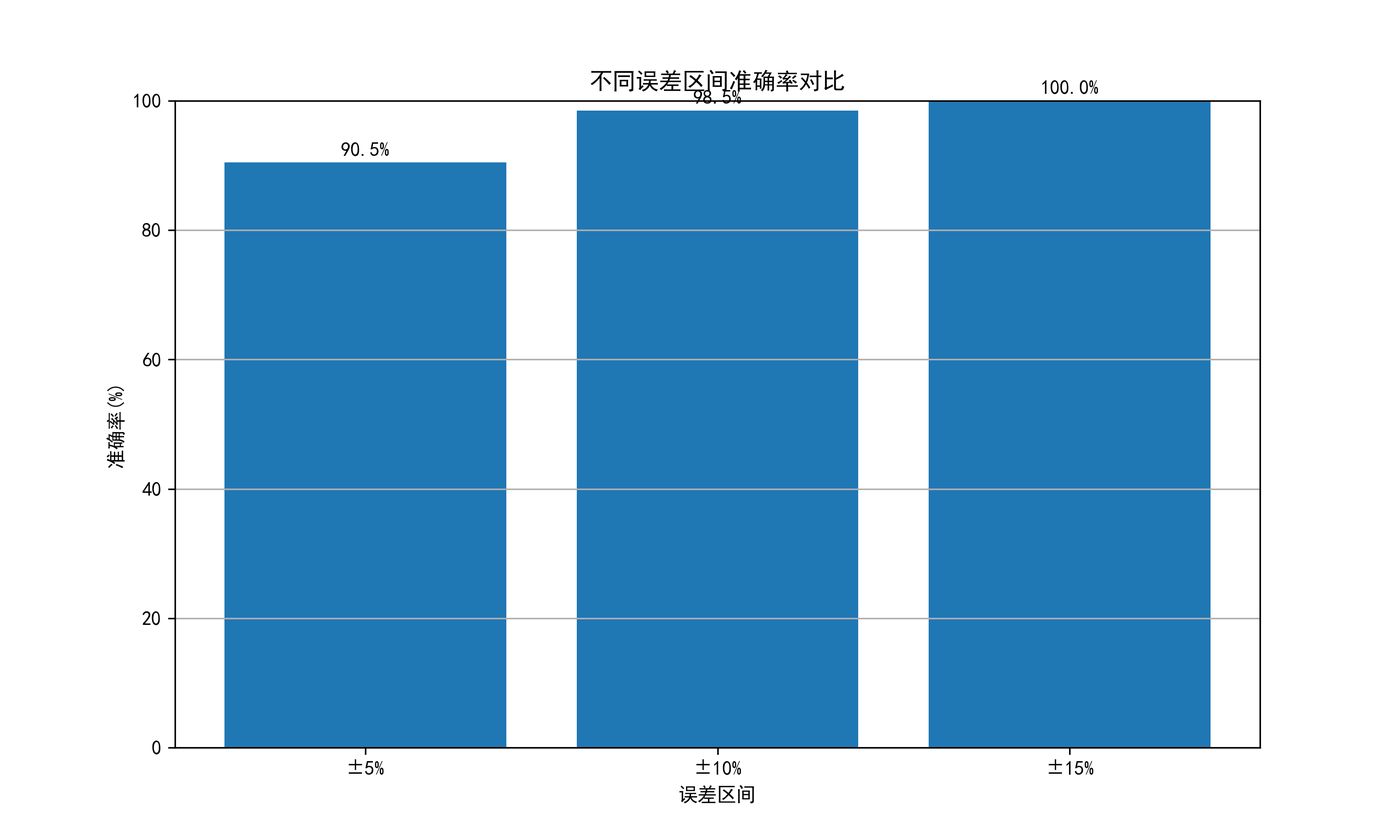 FIG.04误差区间 × 准确率曲线(随机森林 · 综合总分口径):±5% 区间命中 90.5%,±10% 达 98.5%,±15% 达 100%。
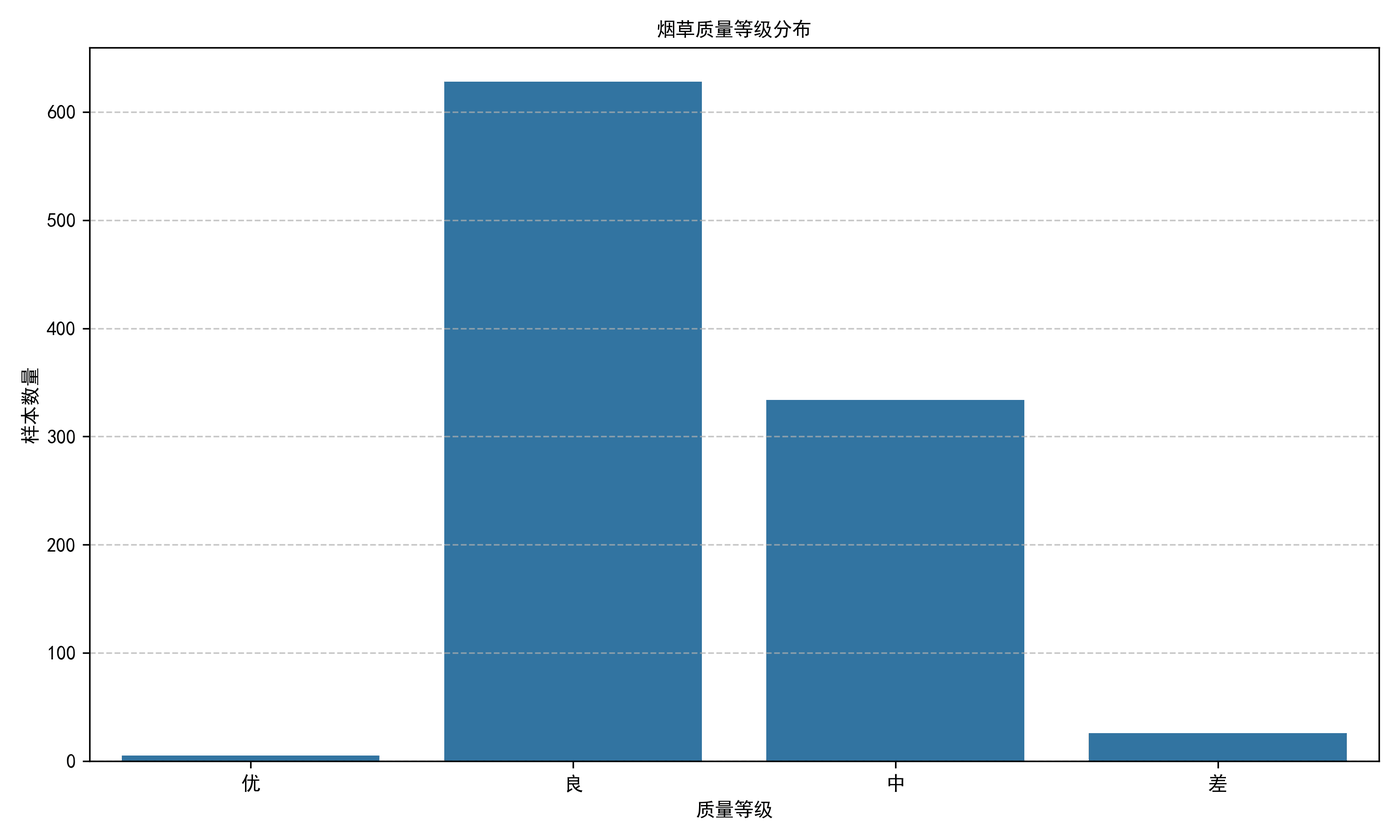 FIG.05全样本质量等级分布:以"良"为主体、"中"次之,"优"与"差"为长尾——等级分布显著不均衡,是四级判定模型的主要挑战。
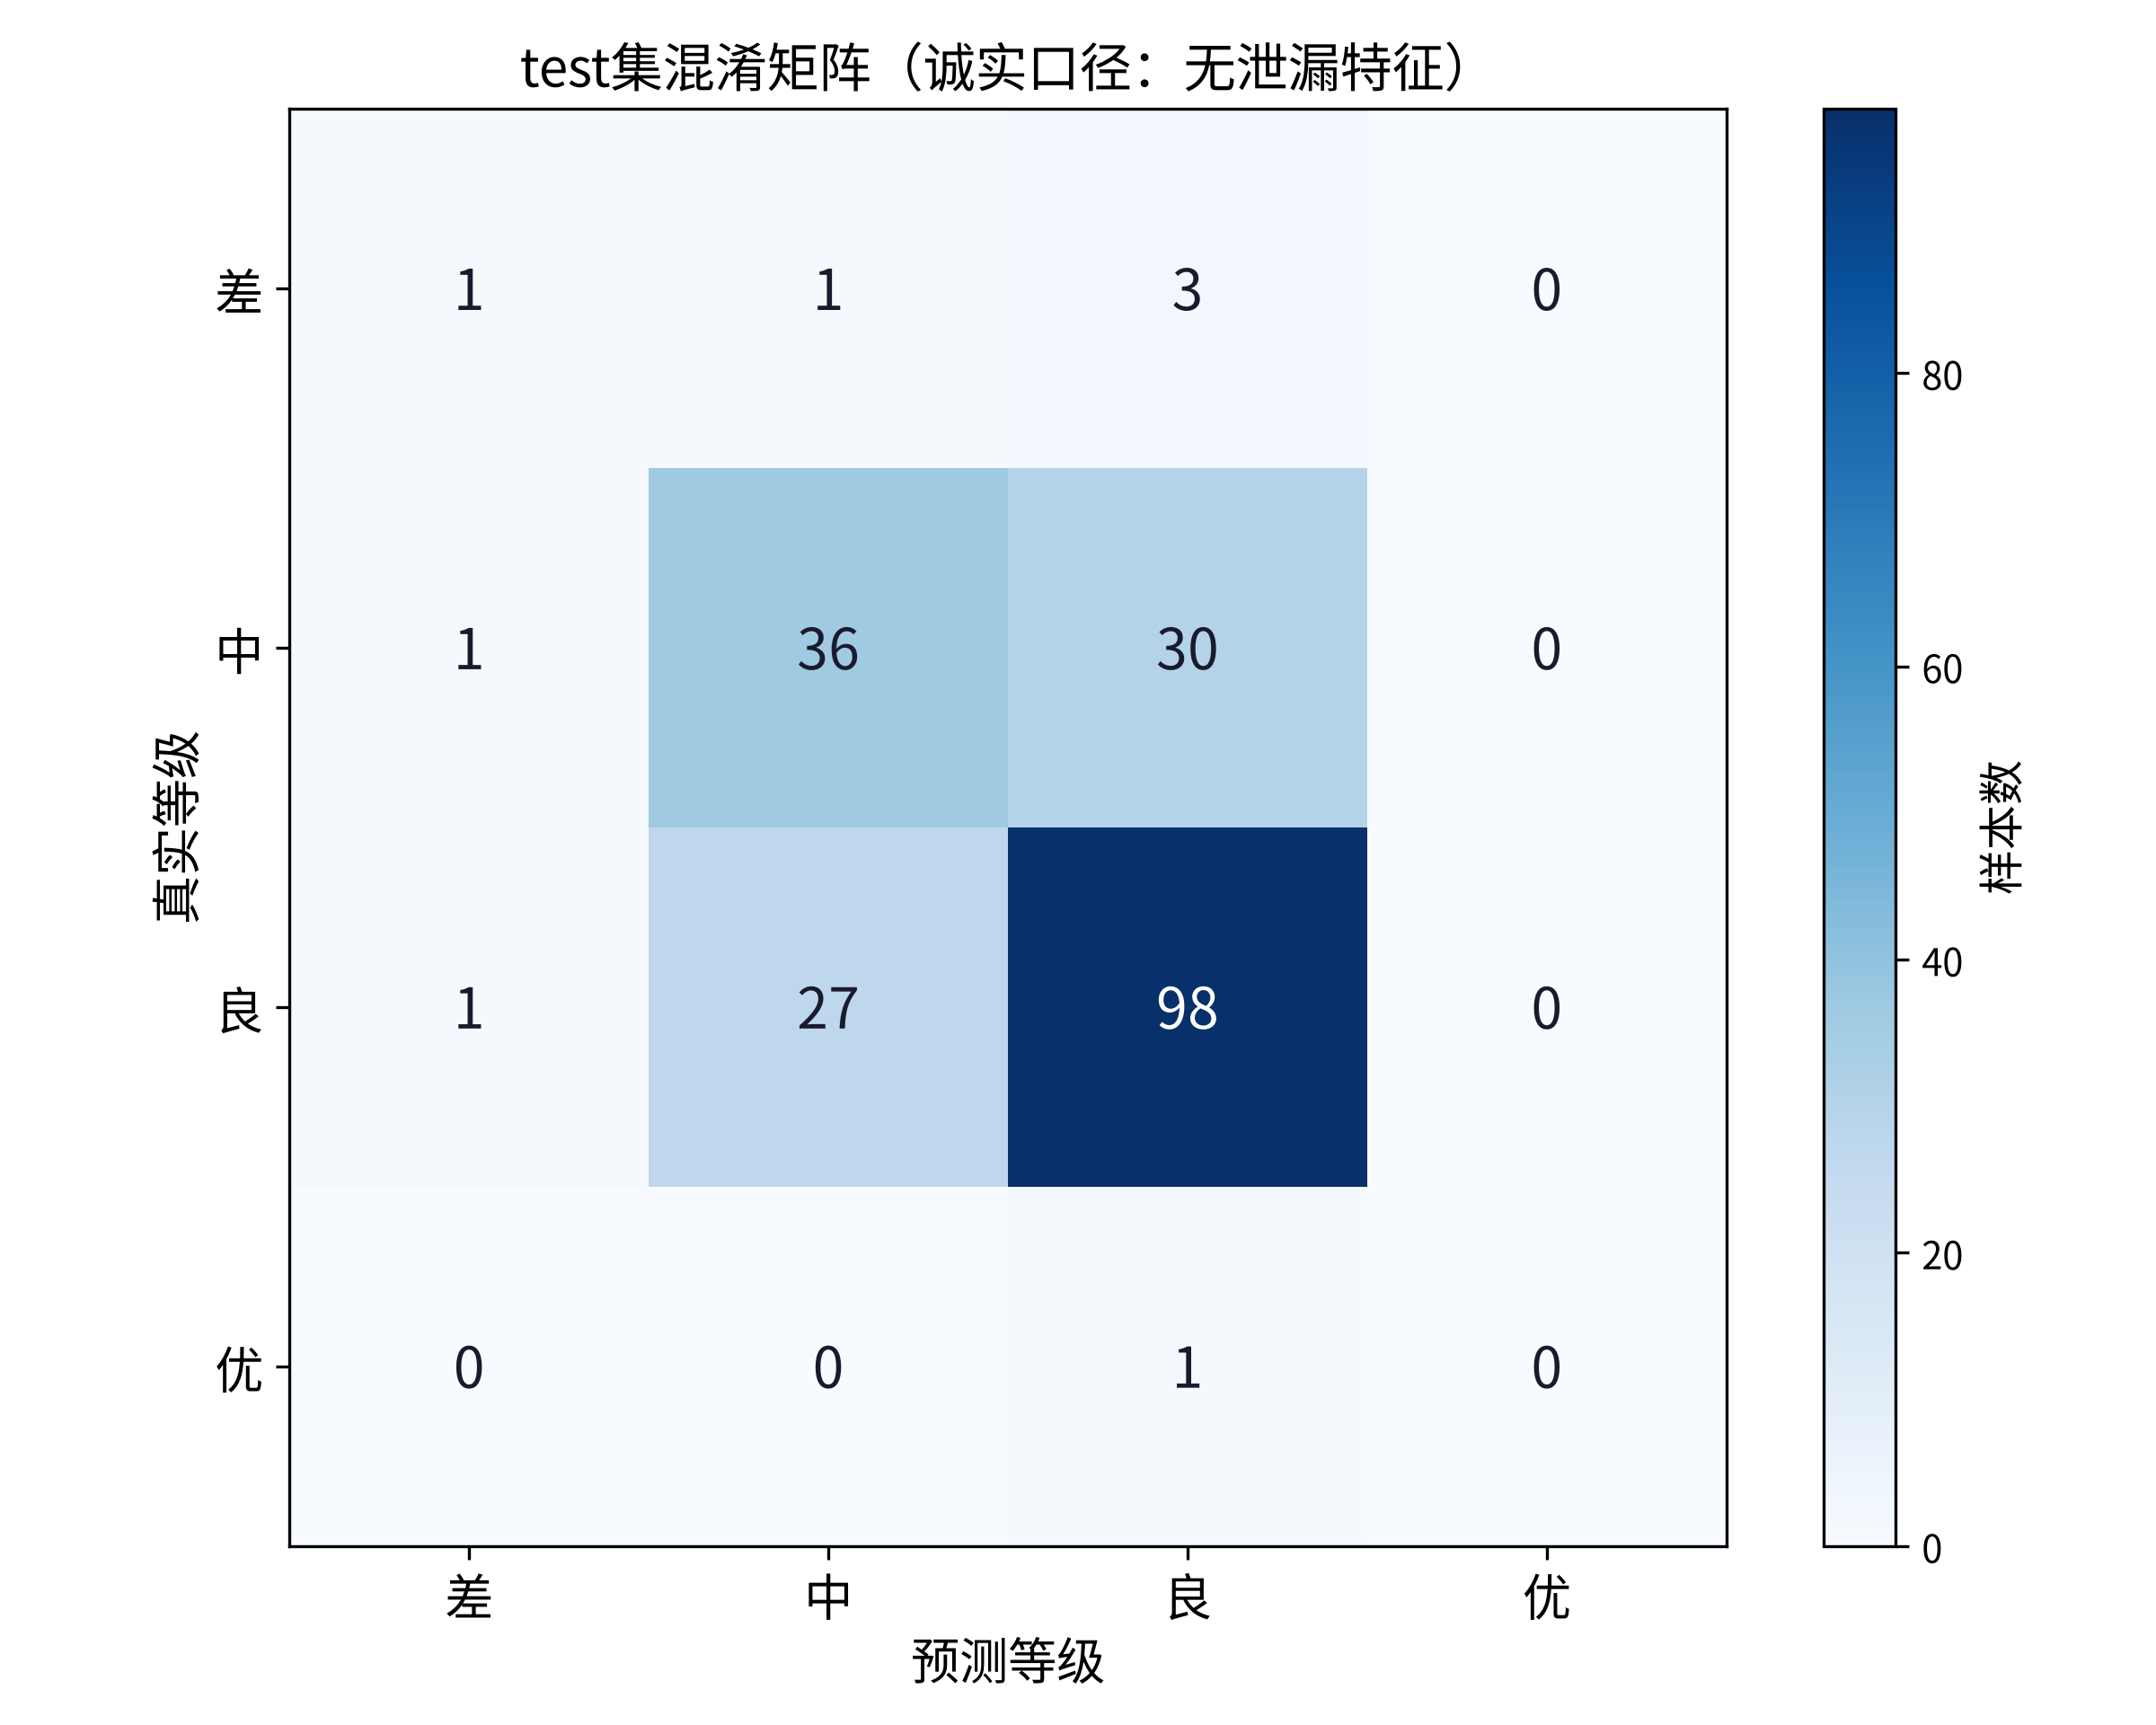 FIG.06质量四级判定测试集混淆矩阵(无泄漏口径):199 份测试样本中 135 份完全一致(67.8%)、195 份相差不超过一级(98.0%)。主要混淆集中在"中↔良"边界(57 例),跨两级误判仅 4 例(差→良 3、良→差 1)。
05 / INSIGHTS
关键驱动因子:打开黑箱
预测之外,模型更重要的价值在于归因——通过置换重要性与 SHAP 分析,量化每项指标对感官质量的贡献方向与强度,让"为什么是这个分数"第一次有了可计算的答案。
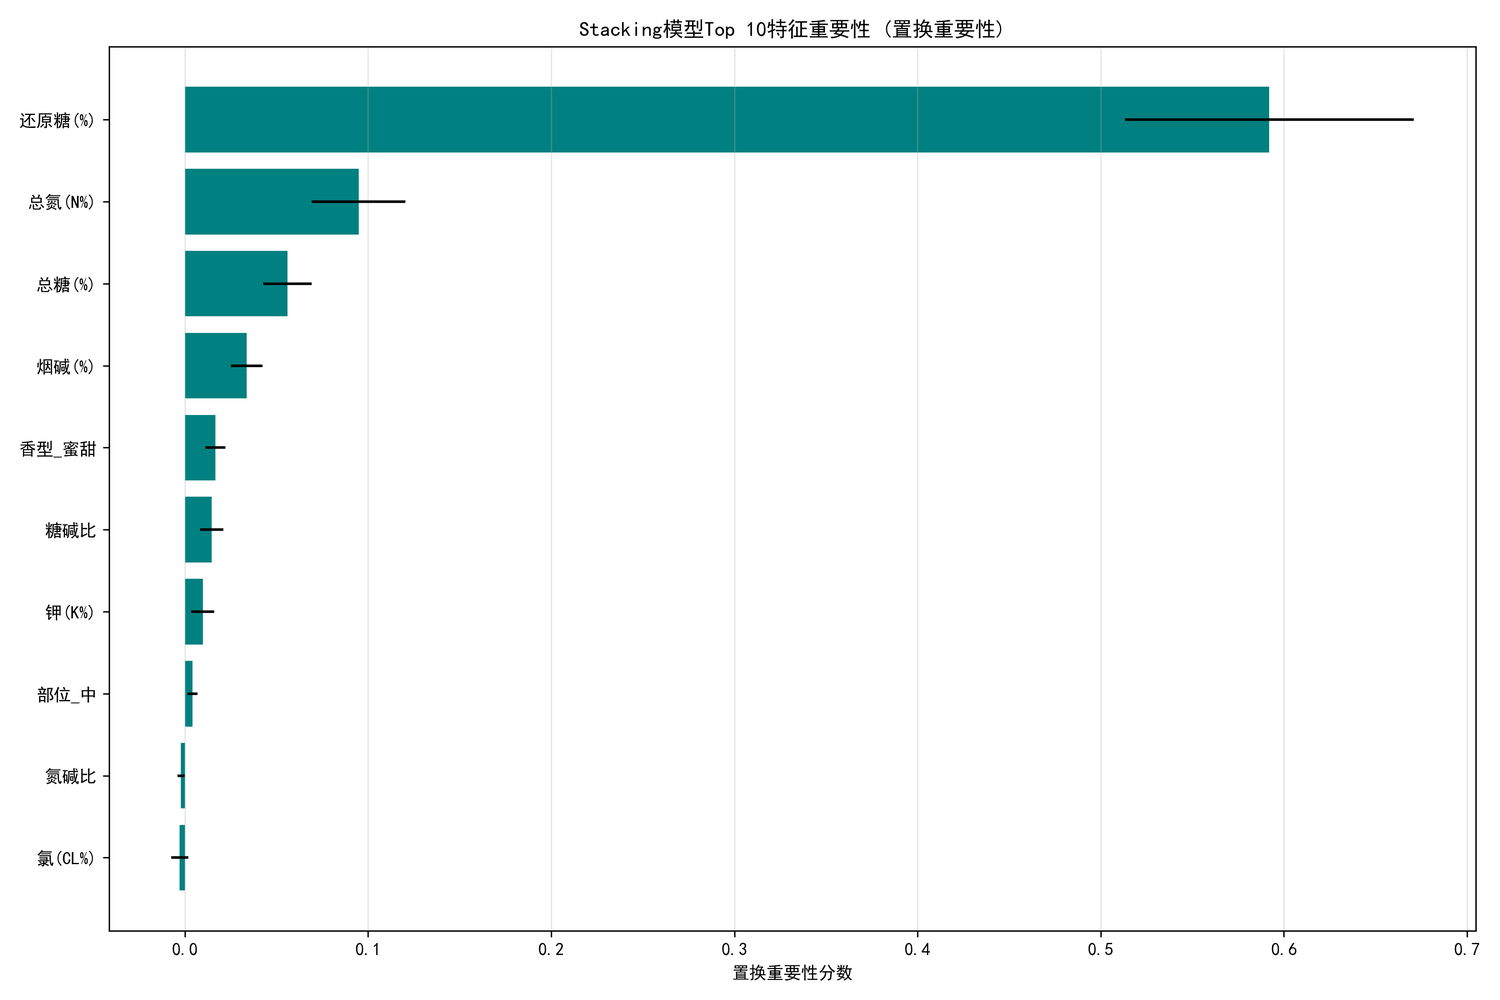 FIG.07Stacking 模型 Top 10 置换重要性:还原糖(0.59)以绝对优势居首,其后为总氮(0.09)、总糖(0.06)、烟碱(0.03)。
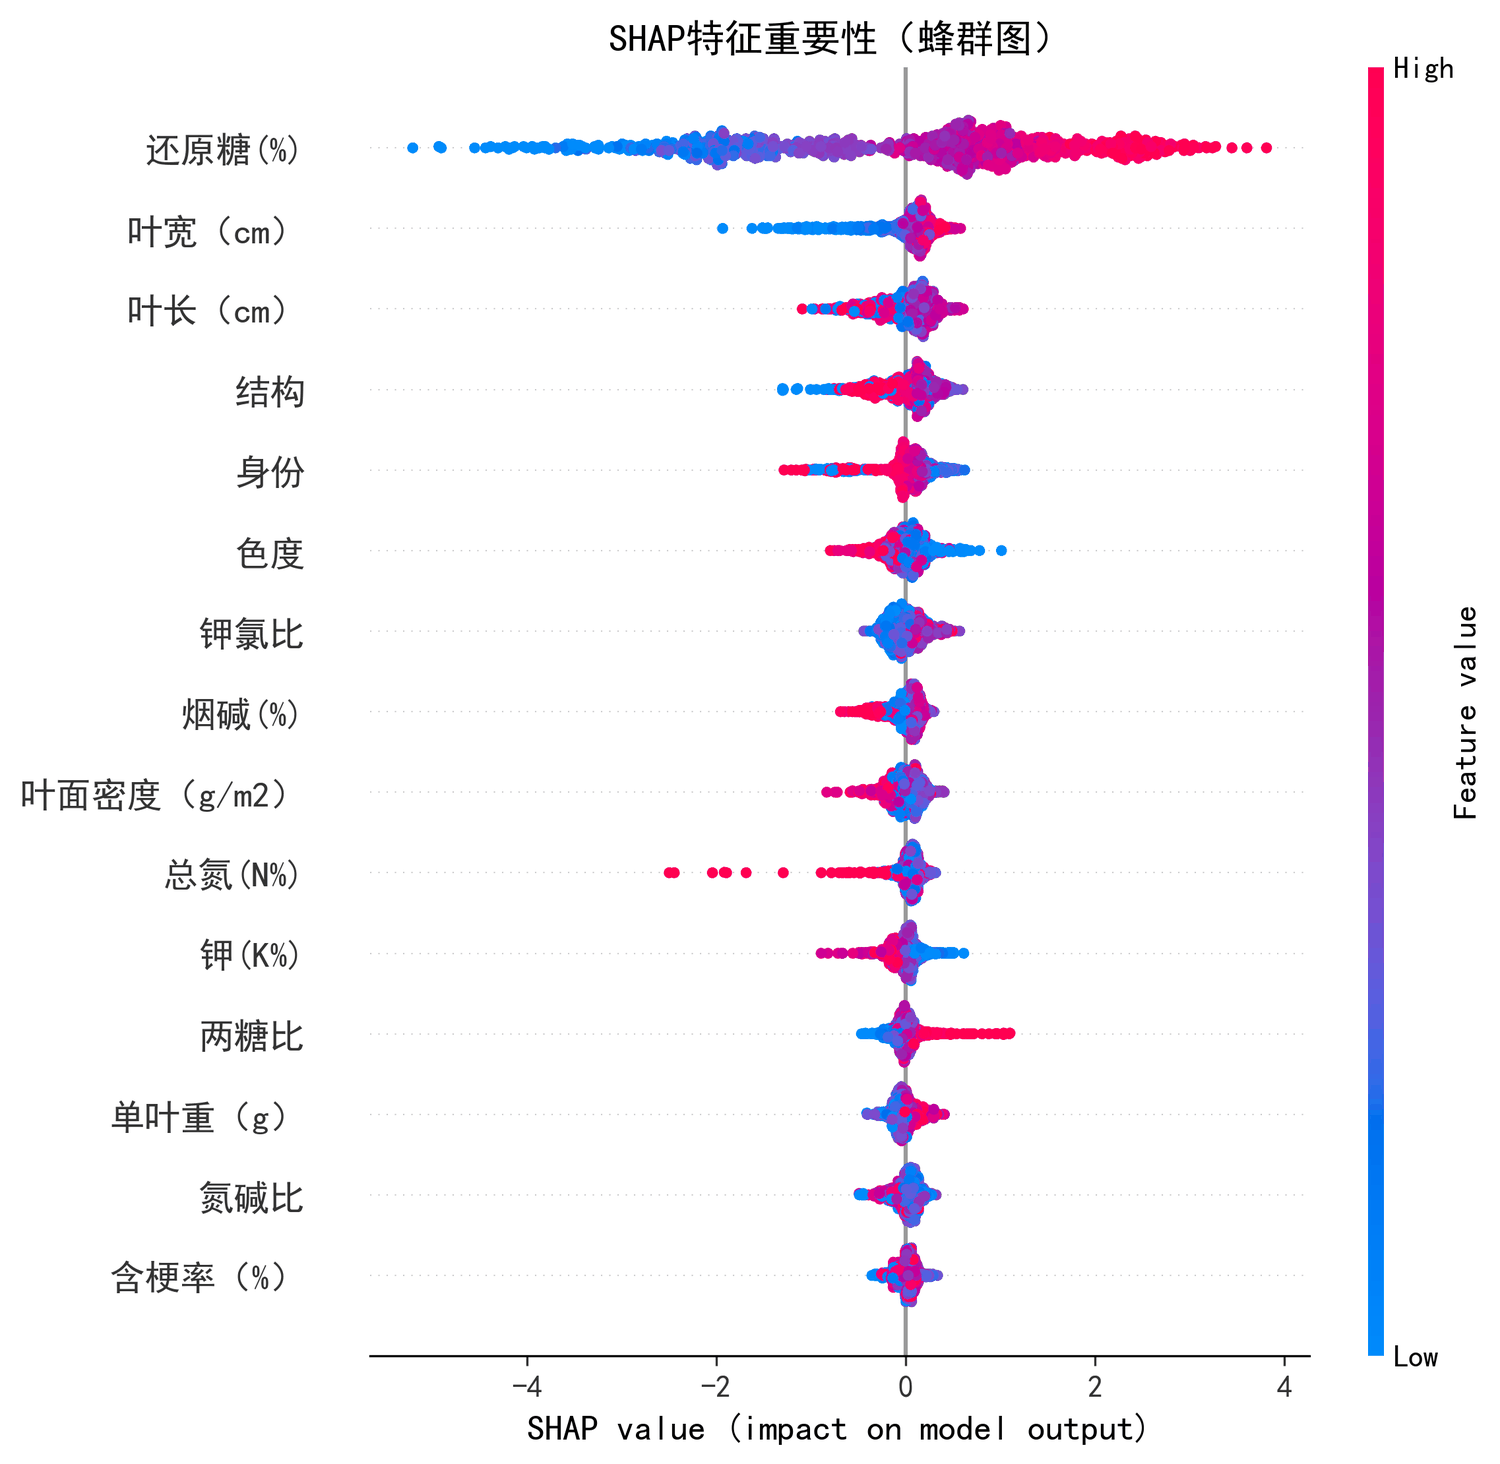 FIG.08SHAP 蜂群图:高还原糖(红色)产生强正向贡献,低还原糖(蓝色)产生强负向贡献;其余特征贡献幅度均在 ±1 以内。
01
还原糖:最重要的单一正相关特征
置换重要性得分 0.59,超过第 2 至第 10 名总和。提高还原糖能有效提升醇和度并掩盖杂气——这与烟叶化学的经典认知高度一致,也验证了模型归因的可靠性。
02
烟碱存在 2.5%–3.5% 的"黄金区间"
烟碱含量处于 2.5%–3.5% 时感官质量最佳;超出该区间(过高)会显著拉低感官分。糖碱比作为协调性指标同样呈现明显的适宜区间效应。
03
总氮与糖代谢协同作用
总氮重要性位列第二(0.09),与还原糖共同构成"糖氮协调"主线——适中的氮素水平有利于香气物质的前体积累。
04
产区禀赋与部位决定质量基线
市州、部位、香型等分类特征稳定进入模型,说明产地生态与部位差异在数据中留下了清晰印记,为产区差异化栽培与收购策略提供依据。
06 / DEEP DIVE
分项预测与分区建模
总分之外,项目对五个感官分项分别建模,并按市州 / 年份 / 部位验证分区建模价值——回答"哪些感官维度最可预测"与"要不要为每个产区单独建模"两个实战问题。
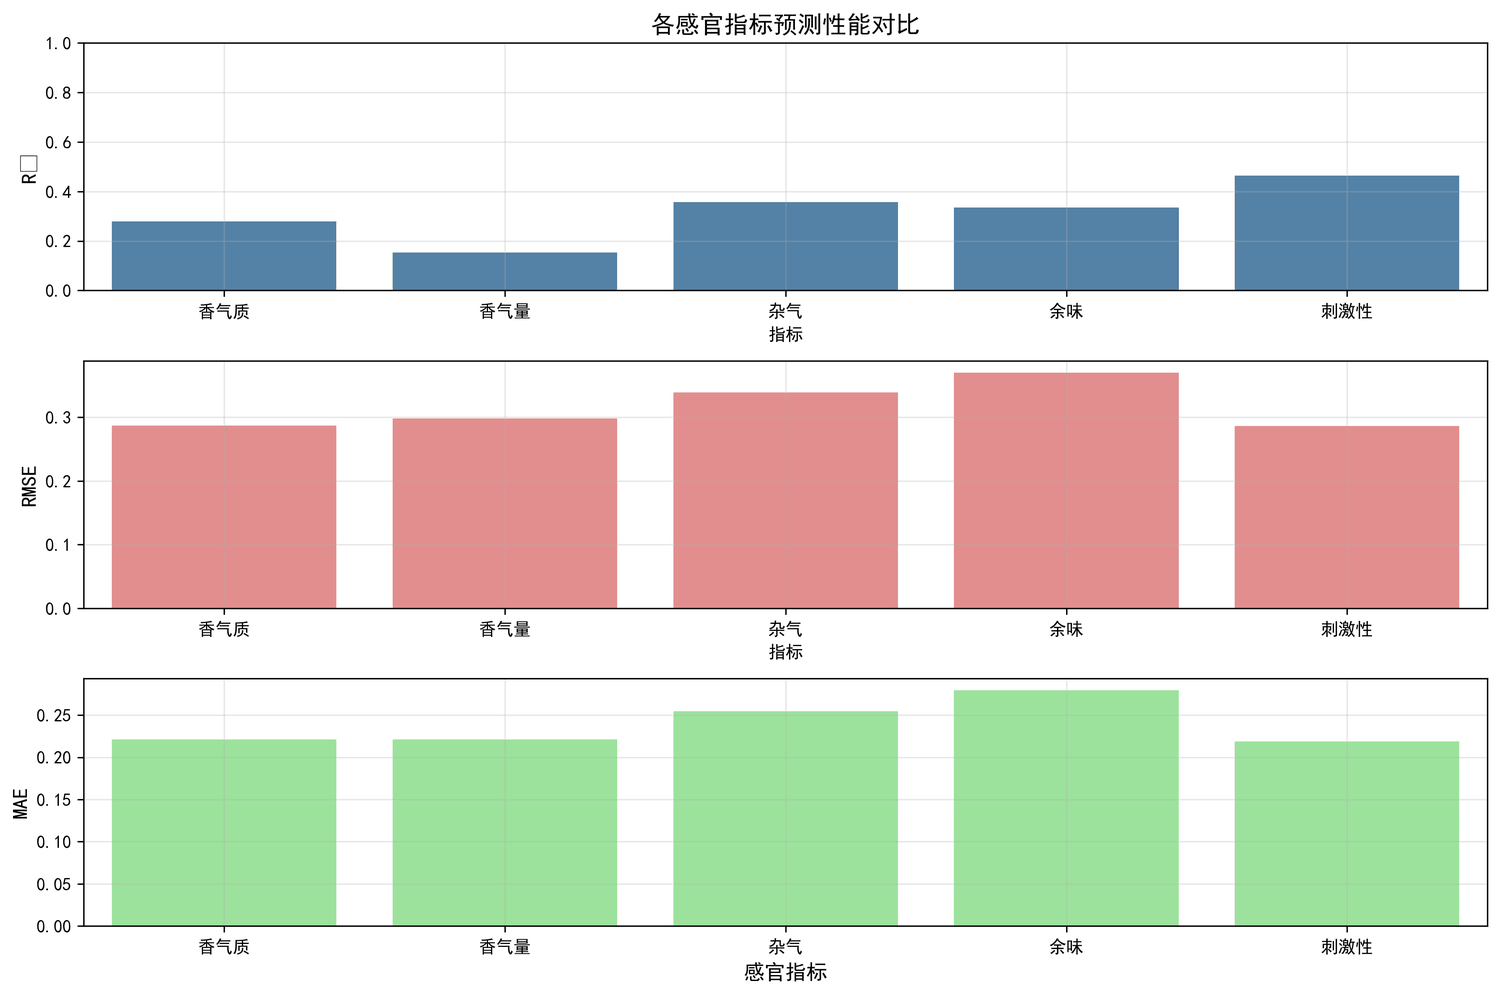 FIG.09五个感官分项的预测性能对比(XGBoost)。
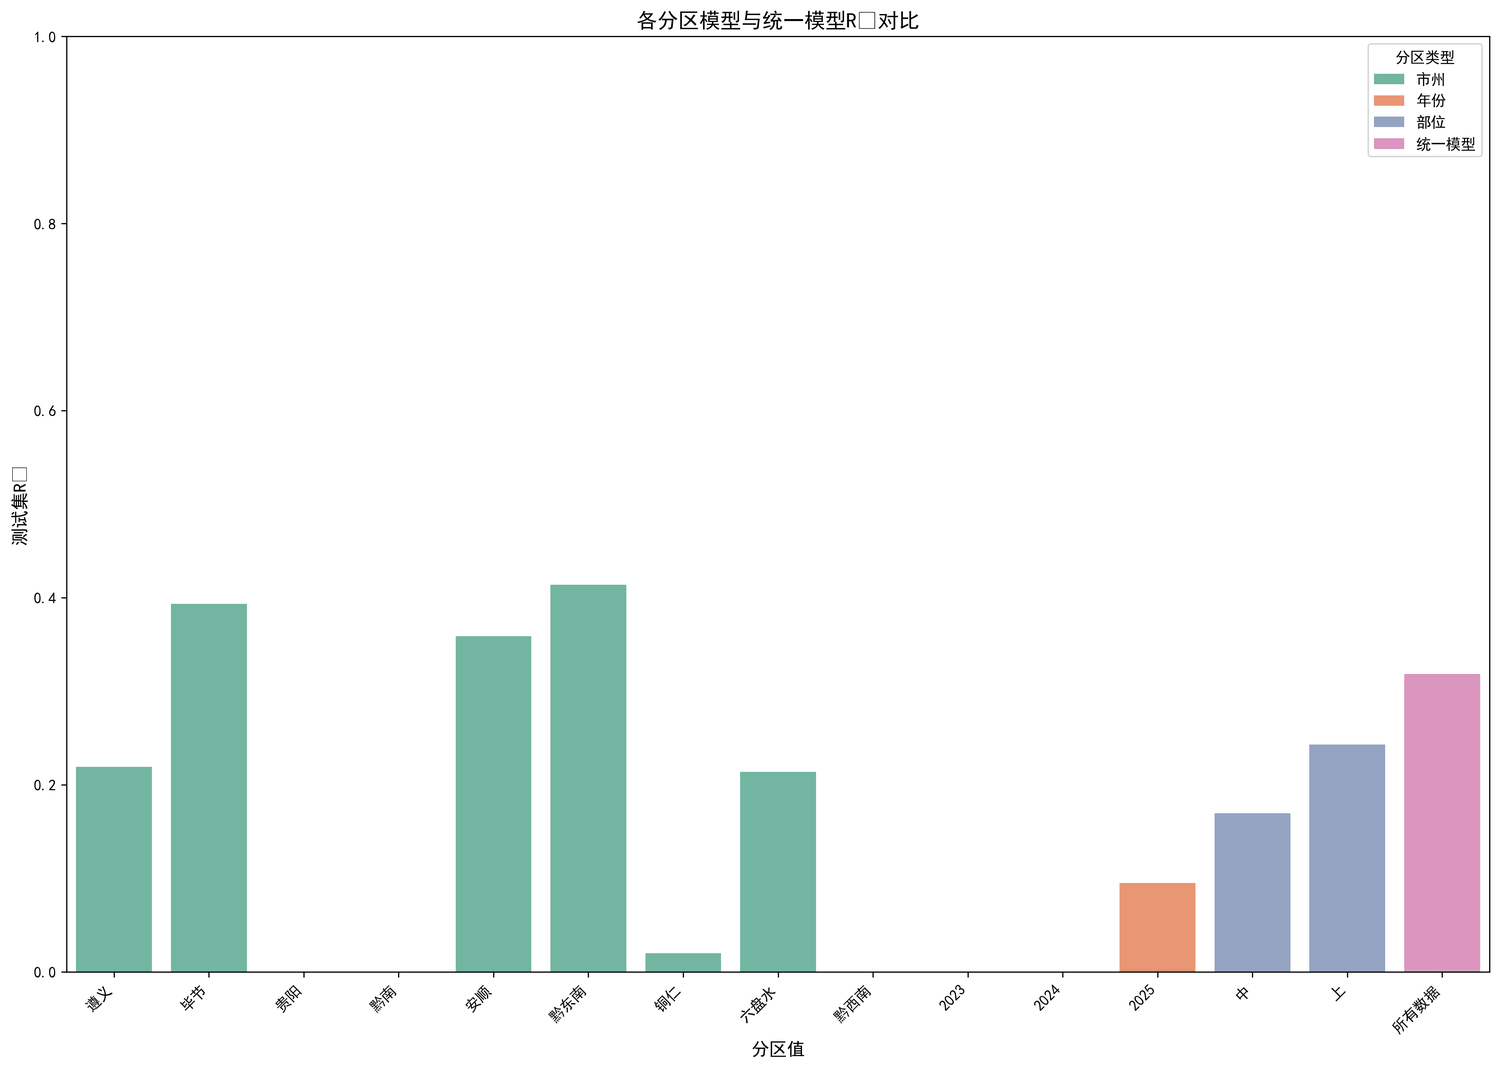 FIG.10分区子模型 vs 统一模型测试集 R²:各市州子模型在 0.02–0.42 间波动,未能稳定超越统一模型(0.32)。
分项可预测性排序
| 感官分项 | R² | RMSE | 解读 |
|---|
| 刺激性 | 0.464 | 0.286 | 最易由理化指标预测 |
| 杂气 | 0.358 | 0.339 | 化学成分解释力较强 |
| 余味 | 0.335 | 0.370 | 中等,需人工复核 |
| 香气质 | 0.279 | 0.287 | 中等偏难 |
| 香气量 | 0.154 | 0.298 | 最难,建议保留人工评吸 |
应用建议:刺激性、杂气可算法辅助评价;香气量依赖挥发性香气物质图谱,现有常规化学指标信息量不足。
分区建模结论:统一大模型更优
- ▸市州分区子模型表现不稳定(R² 0.02–0.42),整体未能超越统一模型——千级样本量下,拆分数据反而削弱训练充分性
- ▸部位分区中上部烟(0.24)略优于中部烟(0.17),提示部位间存在可辨识的建模差异
- ▸分区的真正价值在于揭示区域差异(如黔东南样本可预测性更高),而非提升精度
- ▸数据量是当前最大瓶颈:持续积累样本比模型复杂化收益更高
07 / SYSTEM
从算法到工具:智能预测系统
模型不止于报表——项目同步交付两套可用工具,并把四套 Stacking 模型完整移植进了本页面:下方双模式预测器在浏览器本地运行全部推理(与 Python 模型输出偏差 < 0.001 分)——快测模式凭 8 项化学指标秒出结果,完整模式纳入 19 项指标与产区年份,同步预测感官质量分与综合总分。
浏览器本地推理 · 零网络请求在线智能预测器 · 双模式
四套 Stacking 模型全部参数序列化内嵌本页(XGBoost + PLS [+ SVR] → Ridge 融合),与 Python 原始模型输出偏差 < 0.001 分。快测模式对应 1223 交付版配置,完整模式为精度升级版。
预测综合总分--/ 100
总分 = 0.06 外观 + 0.06 物理 + 0.21 化学 + 0.635 感官(R² = 0.97),由独立模型直接预测
真实样本实测 —— 感官 -- · 总分 -- | 模型偏差:感官 -- · 总分 -- 分
预测分在 993 份样本分布中的位置(竖线为 P25 / 中位 / P75)
拖动指标,预测即时更新。
⚡ 在线轻量版
FLASK + STACKING MODEL · 秒级响应
- 表单输入 8 项化学指标(总糖 / 还原糖 / 总氮 / 烟碱 / 氯 / 钾 / 糖碱比 / 氮碱比)+ 部位 / 香型
- 无需任何人工评分环节,检测结果出来即可预测感官分
- 适用于收购现场快速初判与批量抽检
🖥️ 全功能预测平台
FLASK + SQLITE + LIGHTGBM + ECHARTS
- 用户体系:注册 / 登录 / 权限管理
- 批量预测:Excel 模板上传,一次预测整批样本
- 历史追溯:预测记录入库,支持查询与复现
- 可视化仪表盘:质量分布、趋势与指标概览一屏掌握
▲ 全功能预测平台界面演示(登录 · 数据上传 · 批量预测 · 结果查看)
08 / IMPACT
全链条赋能:从田间到分级
预测体系的价值不止于"算分",而是把质量认知前置到产业链每个环节。
STAGE 1 · 田间管理
种植参数优化
依据关键因子归因(还原糖 / 烟碱区间),反向指导施肥、成熟采收与营养调控
STAGE 2 · 调制工艺
关键指标预警
化学检测值实时映射预测质量分,异常批次提前预警,指导调制工艺调整
STAGE 3 · 工业分级
辅助定级定价
等级判定 ±1 级一致率 98%(完全一致 68%),为分级与定价提供客观参考,减少评吸负担与争议
STAGE 4 · 质量追溯
数据资产沉淀
993 份多维样本持续积累,构建产区质量画像,支撑品牌与原料保障决策
09 / ARCHIVE
项目资料档案
全流程产出的文档、代码与模型资产(完整资料归档于项目组,本页仅作成果展示):
REPORT · PDF
技术报告:基于历史数据关联与关键指标筛选的烟叶感官质量预测与综合质量判定方法
面向委托方的完整技术方案(2025-12-13 版)
REPORT · DOCX
烟叶感官质量与总分预测模型研究报告
模型构建、评估与业务洞察的详细记录
SLIDES · PPTX
烟叶质量算法预测汇报演示文稿
14 页成果汇报:从经验感知到算法预测
CODE · PY
全流程建模脚本
数据治理 / 特征工程 / 模型训练 / SHAP 解释 / 分区与分项建模 / Web 系统
MODEL · PKL
10+ 训练成品模型
XGBoost / LightGBM / SVR / Stacking / 分项模型 / 等级分类器(joblib 序列化)
DATA · XLSX
993 份样本数据集
外观 / 物理 / 化学 / 感官多维指标(已脱敏,不含个体信息)